Modello portatile, nativo di Git per la memoria AI leggibile dagli agenti
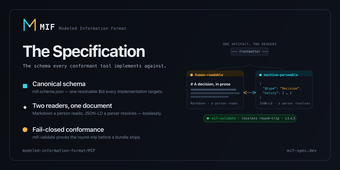
MIF (Formato di Informazioni Modellato), dal Formato di Informazioni Modellato, fornisce un modello di dati neutro rispetto ai fornitori per lo scambio di conoscenze AI portatili. Impacchetta Markdown modificabile dall'uomo e JSON-LD consumabile dalle macchine per creare pacchetti di conoscenza leggibili dagli agenti e locali-prima per assistenti integrati in MCP e flussi di lavoro agentici. Gli elementi chiave includono una sorgente Markdown canonica, proiezioni JSON-LD derivate, provenienza W3C PROV, validità bi-temporale e integrazione con il server MCP. Gli ingegneri AI e i manager della conoscenza lo utilizzano per mantenere la memoria AI nativa di Git e ridurre il sovraccarico di token.
Quali compiti puoi effettivamente utilizzare MIF per?
MIF affronta il problema della memoria AI persistente producendo pacchetti di contesto consumabili dagli agenti che gli agenti possono navigare con alta precisione. Il formato definisce tipi semantici, episodici e procedurali e supporta relazioni tipizzate per mappare entità complesse. I team utilizzano questi pacchetti per esporre contesti strutturati agli assistenti durante la risoluzione dei prompt, per mantenere una fonte di verità modificabile dall'uomo e per rappresentare la conoscenza in un modo che gli agenti possono interrogare programmaticamente.
Quanto sono accurati e tracciabili i progetti leggibili dalle macchine?
I progetti derivati includono metadati allineati a W3C PROV e tracciamento bi-temporale per documentare origine e freschezza, il che migliora la tracciabilità per l'elaborazione a valle. L'accuratezza degli output rivolti agli agenti dipende dalla qualità del Markdown canonico poiché gli esseri umani scrivono la fonte di verità. Praticamente, l'affidabilità aumenta quando gli autori includono campi di provenienza e finestre di validità esplicite durante la scrittura, poiché il formato si basa su quei segnali per prevenire che contesti obsoleti vengano serviti.
Quali input e modelli di distribuzione sono richiesti?
Il flusso di lavoro è nativo del filesystem e di Git, quindi i progetti memorizzano pacchetti di conoscenza come file di testo semplice piuttosto che in database vettoriali esterni. MIF può funzionare come server MCP (mif-mcp) e si integra con client che supportano il Model Context Protocol; la distribuzione si adatta agli ambienti Node.js e TypeScript e alle integrazioni comuni con editor come VS Code. Il design rimuove uno strato di database obbligatorio e consente ai team di mantenere la memoria all'interno di un repository di progetto.
È MIF pratico rispetto ai sistemi di memoria supportati da database?
MIF enfatizza la portabilità neutrale rispetto ai fornitori rispetto alle funzionalità del database utilizzando Markdown semplice come artefatto canonico, il che evita il lock-in a formati di archiviazione proprietari. La sua conformità a OKF aiuta l'interoperabilità con altri strumenti che parlano lo stesso modello di trasporto. I progetti che necessitano di esperimenti rapidi con memoria locale e provenienza esplicita possono adottarlo senza introdurre un archivio vettoriale esterno, anche se l'adattamento delle pipeline esistenti potrebbe richiedere la mappatura degli schemi attuali nel modello di contenuto opinato di MIF.
MIF si adatta ai team di ingegneria che danno priorità a un contesto AI portatile e revisionabile
MIF è un'opzione pratica per ingegneri AI e manager della conoscenza che necessitano di una memoria portatile e locale-prima che gli agenti possano leggere. La sua principale limitazione è la dipendenza da file sorgente curati per la correttezza dell'output, quindi i team dovrebbero aggiungere passaggi di revisione e validazione degli autori nel loro flusso di contenuti. Trattato come parte di un flusso di lavoro di verifica più ampio, si adatta a progetti che preferiscono una memoria nativa del repository rispetto ai servizi di database esterni.